
Hai un modello linguistico che funziona quasi sempre. Estrae il prodotto, estrae la quantità, e poi su una richiesta come «Ci servono otto monitor» aggiunge una data di consegna inventata. Il campo giusto sarebbe null, e a una persona basterebbe un’occhiata per accorgersene. Per un’applicazione che deve fidarsi del risultato, quell’occhiata, invece, non è un’opzione.
A questo punto le strade sono più d’una, puoi riscrivere le istruzioni, puoi fornire al modello documenti di riferimento con un sistema RAG, oppure puoi adattare i suoi parametri con il fine-tuning. Non sono alternative esclusive e non rispondono allo stesso problema. In questo articolo vedremo come distinguerle, capendo quando il fine-tuning vale lo sforzo e, se decidi di procedere, a impostarlo con metodo: dai dati alla valutazione, passando per LoRA e QLoRA.
Che cos’è il fine-tuning di un LLM
Il fine-tuning è un addestramento successivo che adatta un modello già esistente a dati e obiettivi specifici. Interviene sui parametri, i valori numerici appresi durante l’addestramento. Per capire il punto di partenza puoi approfondire i modelli linguistici di grandi dimensioni.
Pre-training, fine-tuning e inferenza
Nel pre-training il modello apprende da un corpus generale. Nel fine-tuning viene adattato a esempi successivi. In inferenza produce risposte usando i parametri disponibili. Una normale conversazione non coincide con un loro aggiornamento.
Il supervised fine-tuning documentato da TRL, o SFT, usa sequenze desiderate per guidare l’apprendimento. Puoi mostrare richieste e risposte oppure conversazioni nel formato atteso dal modello.
Quando conviene fare fine-tuning
Consideralo quando vuoi ottenere un comportamento ricorrente su un compito definito e hai esempi statici ed affidabili per mostrarlo. Nell’estrazione dei tre campi, prima prova il modello base con istruzioni che specifichino come trattare le informazioni mancanti.
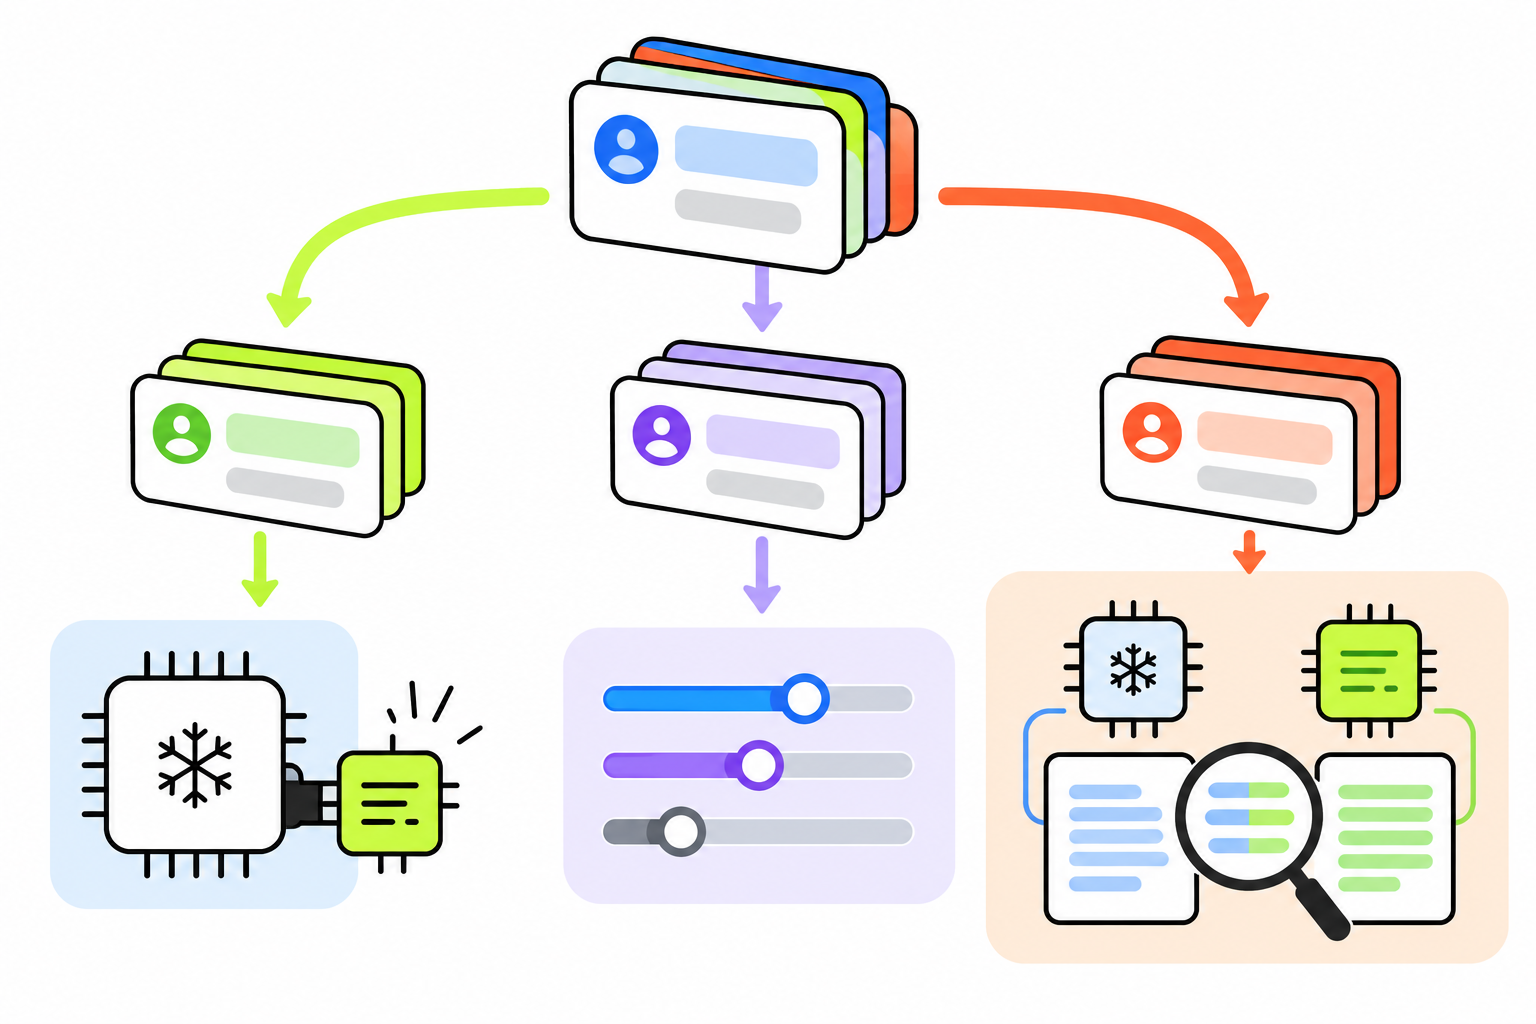
Con il prompt engineering modifichi istruzioni e contenuti dell’input. Un sistema RAG recupera documenti e li fornisce al modello, mentre il fine-tuning ne adatta i parametri. I tre approcci possono convivere. Se il problema è accedere a materiali aggiornati e riferimenti verificabili, approfondisci come impostare un sistema RAG da zero.
Conserva una base di confronto con le risposte ottenute dal modello originale. Ti servirà per stabilire se l’adattamento corregge gli errori che ti interessano o ne introduce altri.
Quale tecnica di fine-tuning scegliere
Full fine-tuning: caratteristiche, vantaggi e costi
Il full fine-tuning aggiorna tutti i parametri. Richiede risorse diverse dall’adattamento di pochi parametri aggiunti, senza garantire risultati superiori su ogni compito. Il paper originale di LoRA affronta proprio il problema di rendere più gestibile l’adattamento di modelli grandi.
LoRA e QLoRA per addestrare gli adapter
LoRA, Low-Rank Adaptation, congela i pesi pre-addestrati e introduce matrici addestrabili più piccole. Questi parametri aggiunti formano gli adapter. Il rango indica la dimensione della decomposizione utilizzata.
QLoRA, Quantized Low-Rank Adaptation, combina adapter LoRA con una base congelata quantizzata a 4 bit, cioè rappresentata con precisione ridotta. Il paper QLoRA descrive il metodo. Gli aggiornamenti riguardano gli adapter, anziché tutti i pesi quantizzati.
PEFT e obiettivo di apprendimento
PEFT, Parameter-Efficient Fine-Tuning, raccoglie metodi che limitano i parametri da addestrare. LoRA appartiene a questa famiglia. Il Supervised Fine Tuning (SFT) descrive l’apprendimento dagli esempi e può essere realizzato con LoRA o QLoRA.
Come preparare il dataset
Obiettivo, esempi e formato delle conversazioni
Definisci lo schema dei campi prima di raccogliere esempi. Nel nostro esercizio didattico, il prodotto e la quantità devono provenire dalla richiesta, una consegna non specificata deve restare assente.
Input: Ci servono otto monitor.

Output atteso: {"prodotto":"monitor","quantita":8,"data_consegna":null}
Aggiungi formulazioni diverse e campi omessi, includendo anche richieste ambigue. Ogni esempio deve mostrare una risposta che consideri corretta.
Nei dataset conversazionali, role identifica chi parla e content contiene il messaggio. Il chat template organizza i messaggi nei token attesi dalla base, le unità in cui viene suddiviso il testo. Modelli diversi possono richiedere strutture differenti.
Training, validazione e test: qualità e separazione
Usa il training per aggiornare i parametri e la validazione per confrontare configurazioni. Tieni da parte un test finale, da usare per misurare il risultato. Hugging Face Datasets documenta come creare le partizioni.
Controlla errori e dati sensibili prima del training. Rimuovi duplicati e richieste quasi identiche fra le partizioni: il data leakage, cioè la contaminazione del confronto con informazioni già usate, può far apparire il modello più efficace su casi nuovi di quanto sia.
Come eseguire il fine-tuning
Configurare adapter e iperparametri
Parti da una configurazione documentata per il modello scelto. Il learning rate regola l’ampiezza degli aggiornamenti, il batch size gli esempi elaborati insieme e le epoche i passaggi sui dati. Con LoRA scegli anche rango e moduli da adattare. QLoRA aggiunge la quantizzazione della base.
La guida TRL mostra questo nucleo per il training con adapter:
from datasets import load_dataset

from peft import LoraConfig

from trl import SFTTrainer
trainer = SFTTrainer(

    "Qwen/Qwen3-0.6B",

    train_dataset=load_dataset("trl-lib/Capybara", split="train"),

    peft_config=LoraConfig(),

)

trainer.train()
Lo script Python sopra usa un dataset conversazionale dimostrativo, distinto dagli esempi di estrazione del nostro progetto. Prima di adattarlo, configura dati e valutazione del tuo compito.
Gestire memoria, monitoraggio e salvataggio
La gradient accumulation accumula gradienti su più mini-batch prima di aggiornare i pesi. Il gradiente indica come modificare i parametri rispetto all’obiettivo di training. Il gradient checkpointing conserva solo parte delle attivazioni intermedie, ricalcolando le altre per risparmiare memoria.
Osserva memoria e loss, la misura dell’errore sull’obiettivo di addestramento. Salva i checkpoint, cioè gli stati del lavoro. Per riutilizzare l’adapter conserva configurazione, tokenizer e riferimento preciso alla base, compresa la revisione. La guida ai checkpoint PEFT distingue i parametri dell’adapter dai pesi originali, che servono ancora per caricarlo.
Come valutare il modello fine-tuned
Confrontare formato, contenuto e casi limite
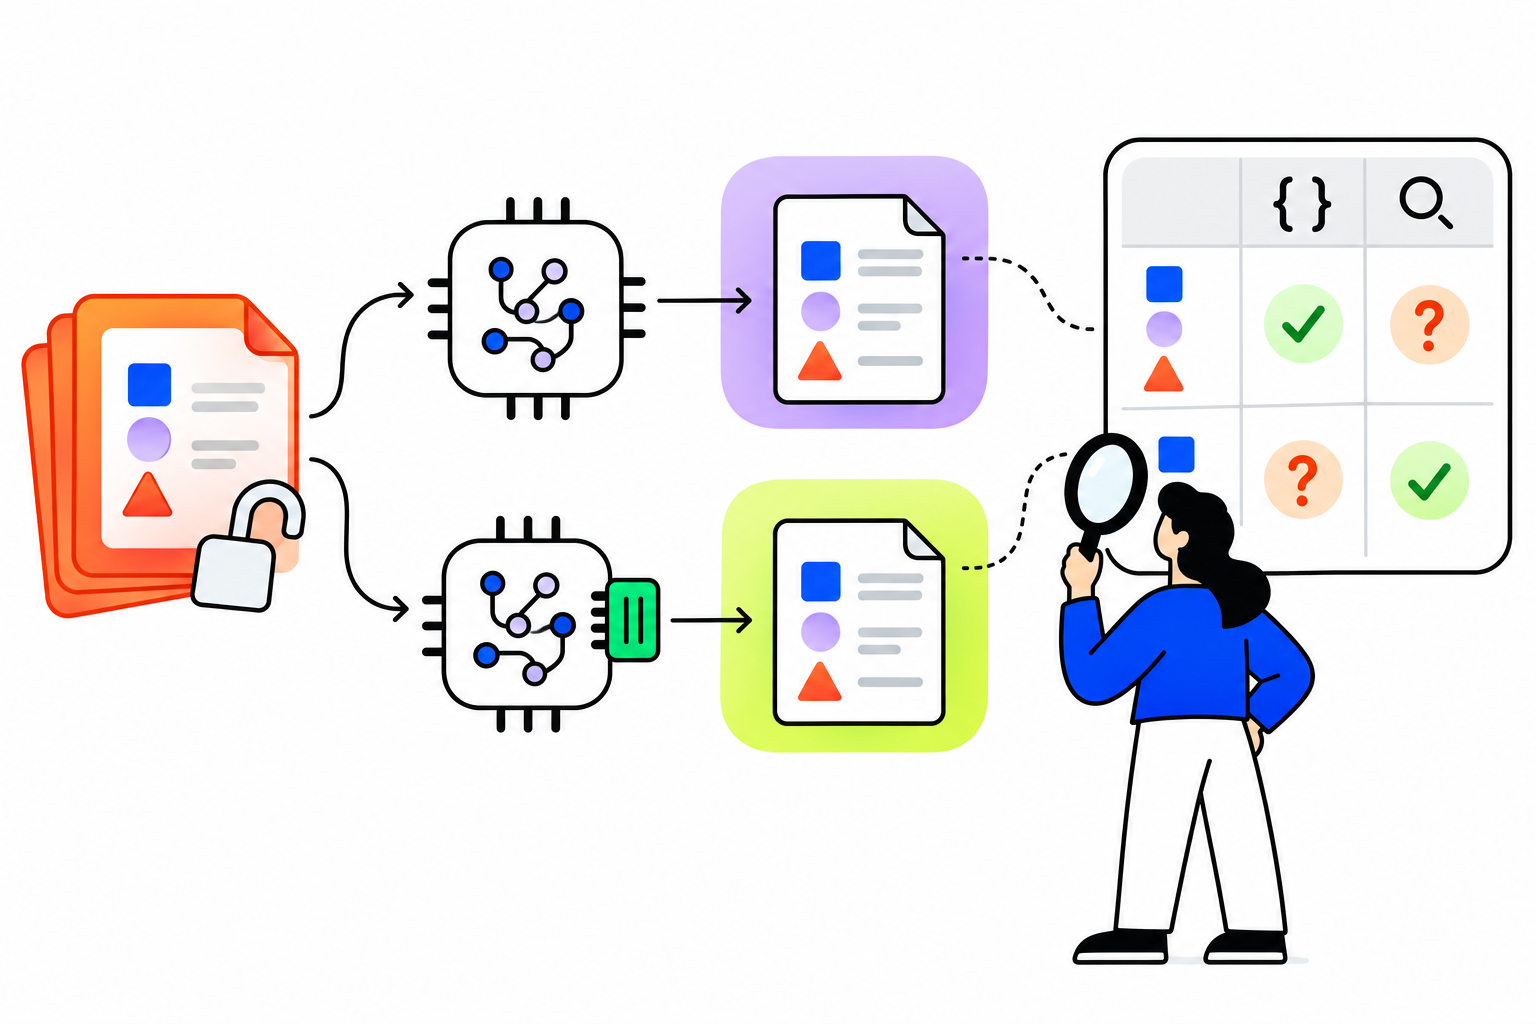
Sottoponi modello base e adattato agli stessi esempi riservati, con istruzioni e criteri coerenti. Controlla separatamente formato e contenuto: un JSON valido può riportare una quantità sbagliata.
Nel nostro esercizio, verifica che prodotto e quantità siano fedeli all’input e che la consegna assente diventi null. Se la richiesta dice “venerdì”, conserva l’espressione o chiedi il riferimento temporale prima di convertirla in una data. Aggiungi richieste incomplete, ambigue e fuori ambito per cercare anche regressioni.
Metriche automatiche e revisione umana
Puoi automatizzare la verifica dello schema e il confronto dei campi. Hugging Face Evaluate offre strumenti per calcolare metriche del compito. La loss di training misura un obiettivo diverso dalla correttezza di ciascuna estrazione.
Affianca una revisione umana alle metriche, soprattutto per gli errori che richiedono contesto. Stabilisci anche quali risposte inappropriate o rischiose renderebbero il modello inadatto alla tua applicazione.
Come distribuire un modello fine-tuned
Adapter, merge e quantizzazione
Puoi caricare base e adapter insieme oppure integrarli mediante il merge, quando metodo e configurazione lo consentono. PEFT documenta merge_and_unload(), con vincoli che riguardano anche alcune configurazioni quantizzate.
La quantizzazione modifica la rappresentazione numerica dei pesi. Dopo merge o conversioni, ricontrolla gli output e la compatibilità con il motore di inferenza scelto.
Applicazione, API e monitoraggio
L’applicazione deve inviare richieste nel formato previsto e gestire le risposte. Un’API è l’interfaccia attraverso cui può comunicare con il servizio del modello.
Durante l’uso, registra errori, tempi e risorse secondo i criteri scelti per l’esperimento. Conserva la configurazione distribuita per poter risalire alla versione che ha prodotto una risposta problematica.
Errori da evitare nel fine-tuning
Se due revisori ricavano quantità diverse dalla stessa richiesta, correggi le annotazioni incoerenti prima di aumentare il training. Aggiungere esempi con risposte in conflitto rende meno chiaro il comportamento da apprendere.
Un test contaminato da dati usati per scegliere la configurazione richiede un nuovo confronto riservato. Se invece i messaggi arrivano al modello nel formato sbagliato, controlla il template. Aumentare epoche e dimensioni della base non sostituisce questi controlli.
Quanto costa fare fine-tuning a un LLM
Nel budget considera la preparazione dei dati, le risorse di calcolo e i tentativi necessari per valutare le configurazioni. Dopo il training serviranno anche risorse per eseguire il modello.
Misura una prova ridotta, annotando tempo e memoria utilizzati insieme al lavoro di revisione. Usa queste osservazioni per stimare il passaggio successivo. LoRA e QLoRA cambiano il fabbisogno, ma non forniscono un preventivo universale.
Come iniziare con un progetto di fine-tuning
Prepara un set di confronto per i tre campi e prova il modello base con istruzioni curate. Sperimenta un adattamento quando hai esempi coerenti e un criterio di riuscita da verificare.
Per approfondire l’integrazione con applicazioni e sistemi RAG, il Corso AI Engineer include anche fondamenti di fine-tuning. Nel tuo esperimento, annota per ogni richiesta quali campi sono corretti e quali informazioni sono state aggiunte senza essere presenti nell’input.

AUTORE:Simone Truglia Apri profilo LinkedIn
Simone è un Ingegnere Informatico con specializzazione nei sistemi automatici e con una grande passione per la matematica, la programmazione e l’intelligenza artificiale. Ha lavorato con diverse aziende europee, aiutandole ad acquisire e ad estrarre il massimo valore dai principali dati a loro disposizione.


