
Un agente AI che deve controllare un contratto può impiegare pochi secondi per leggere una clausola e molto più tempo per confrontarla con altri documenti. Se poi deve interrogare un gestionale, ogni passaggio aggiunge lavoro. Quale modello scegliere per sostenere carichi simili di lavoro senza far lievitare troppo tempi e costi?
NVIDIA Nemotron è una famiglia di modelli AI open weights pensati soprattutto per costruire agenti e applicazioni aziendali. Comprende modelli linguistici per il ragionamento e varianti capaci di interpretare anche i contenuti visivi.
Per orientarsi, però, vediamo quali novità introduce la serie 3.5, in cosa si differenziano i vari modelli e come accedere.
Cos’è NVIDIA Nemotron e a cosa serve
Nemotron mette a disposizione degli sviluppatori dei modelli da integrare all’interno dei propri software. Puoi usarli attraverso un servizio API oppure scaricare i pesi delle versioni disponibili ed eseguirli su un’infrastruttura compatibile.
Il progetto si inserisce nel lavoro sull’AI generativa di Nvidia, che già qualche anno fa aveva sviluppato eDiff-I, il modello AI text-to-image dell’azienda. Qui l’attenzione si concentra sull’Agentic AI, quindi su sistemi strutturati per comprendere l’ambiente in cui operano, prendere decisioni in autonomia e, in generale, agire per raggiungere obiettivi specifici, anche comunicando con strumenti esterni.
Un’applicazione basata su Nemotron può, per esempio, esaminare una richiesta di assistenza ricevuta dal Servizio Clienti e cercare nei documenti aziendali le informazioni necessarie per rispondere. Se deve anche controllare lo stato di un ordine, avrà bisogno di un collegamento al gestionale.
È quindi importante distinguere il modello dall’agente che lo utilizza. Nemotron elabora le informazioni e può richiedere l’uso di uno strumento; il software dell’agente esegue le operazioni e gestisce le autorizzazioni.
Come funziona Nemotron
Per capire come funziona Nemotron, dobbiamo guardare sia all’architettura dei modelli sia alle modalità con cui affrontano le richieste.
L’architettura Mixture of Experts
I principali modelli della serie Nemotron 3 adottano un’architettura Mixture of Experts, spesso abbreviata in MoE. Il modello comprende diversi gruppi di parametri, chiamati “esperti” (reti neurali specializzate), e ne utilizza solo una parte per elaborare ciascun token, cioè una delle unità in cui viene suddiviso il testo.
Nemotron 3.5 Super VL, per esempio, possiede 120 miliardi di parametri totali e ne attiva circa 12 miliardi per token. Questo permette di ridurre il calcolo necessario rispetto all’impiego di tutti i parametri a ogni passaggio, ottimizzando così i costi di calcolo computazionale.
I parametri attivi, però, non bastano per darci una stima di quanta memoria servirà. Per eseguire il modello bisogna considerare anche il peso complessivo dei file e la memoria occupata durante l’elaborazione.
L’architettura integra inoltre componenti Mamba-2 e Transformer, che contribuiscono a gestire sequenze estese. Caratteristica importantissima per agenti AI di questo tipo, che nel corso di un’attività devono elaborare anche i risultati delle operazioni precedenti.
Il ragionamento e l’uso di strumenti esterni
Nei modelli Nemotron che lo prevedono, puoi decidere quanto spazio dedicare al ragionamento prima della risposta finale.
Un’elaborazione più lunga, infatti, può produrre output migliori per risolvere problemi particolarmente complessi o gestire attività molto articolate, ma richiede più tempo e genera più token. Per rispondere a una richiesta semplice, quindi, potrebbe essere sufficiente la modalità rapida di ragionamento.
Il collegamento con gli strumenti esterni avviene attraverso il tool calling. Il modello può richiedere, per esempio, una ricerca nel catalogo prodotti di un sito web; l’applicazione esegue la funzione e gli restituisce i dati da usare nella risposta.
La serie 3.5 introduce anche tecniche per accelerare la generazione, come la Multi-Token Prediction. Il sistema propone più token successivi e ne verifica l’accettabilità, così da ridurre i passaggi necessari per produrre il testo.
Quali modelli include la famiglia Nemotron
I nomi Nano, Super e Ultra identificano i modelli della famiglia Nemotron in base a dimensioni e capacità. Nel tempo NVIDIA ha aggiunto altre versioni, comprese quelle della serie 3.5, per rispondere a esigenze più specifiche.
Per orientarti, abbiamo raccolto in questa tabella i vari modelli con le loro ottimizzazioni.
| Modello | Caratteristiche e impieghi |
|---|---|
| Nemotron Bolt | Esegue le attività quotidiane degli agenti AI in locale, gestendo la velocità e la capacità necessarie per affrontare ragionamenti multi-step, utilizzare strumenti e navigare sul web. |
| Nemotron Nano | Offre un’elevata accuratezza a costi contenuti per i sotto-agenti specializzati. La variante Nano Omni aggiunge capacità multimodali. |
| Nemotron Lightning | È progettato per offrire la massima efficienza nelle attività specializzate degli agenti che operano in modo continuativo. |
| Nemotron Super | Punta alla massima efficienza con un’elevata accuratezza nel ragionamento, nell’uso degli strumenti e nelle attività agentiche multimodali. |
| Nemotron Ultra | È pensato per le applicazioni che richiedono la massima accuratezza di ragionamento nelle attività agentiche complesse. |
Puoi anche usare più modelli nello stesso progetto. Al modello più performante, quindi, potresti assegnare il compito di organizzare il lavoro che, in un secondo momento, affiderebbe a quello veloce le operazioni più semplici.
Nemotron 3.5 Super VL per documenti e contenuti visivi
La sigla VL sta per vision-language e indica la capacità di elaborare contenuti visivi insieme al testo. Nemotron 3.5 Super VL può quindi interpretare una tabella presente in una pagina oppure analizzare un grafico insieme alle informazioni che lo accompagnano.
Per farlo utilizza un encoder visivo, C-RADIO, che trasforma le immagini in rappresentazioni utilizzabili dal modello linguistico. Gli input supportati comprendono testo, immagini e video.
La finestra di contesto arriva fino a un milione di token, ovvero lo spazio condiviso da istruzioni, materiali forniti e risposta. Naturalmente la capacità effettivamente disponibile dipende anche dalla configurazione e dalla memoria del sistema.
Nemotron 3.5 Bolt per lavorare in locale
La linea Bolt è pensata per lavorare con gli agenti AI su dispositivi locali. La versione 74B-A9B 24GB utilizza una quantizzazione nativa a 2 bit, una tecnica che riduce la memoria necessaria per rappresentare i pesi del modello.
NVIDIA la propone per l’esecuzione in 24 GB di memoria nelle configurazioni previste. Prima di installarla, resta necessario controllare i requisiti: la lunghezza delle richieste e il numero di utenti serviti possono incidere sul consumo.
Nella stessa linea rientra Bolt E4B 4GB, dedicato ad agenti conversazionali compatti. Il suo rilascio è annunciato per ottobre 2026.
Come usare Nemotron
Puoi scaricare i modelli NVIDIA Nemotron da Hugging Face ed eseguirli gratuitamente anche in produzione.
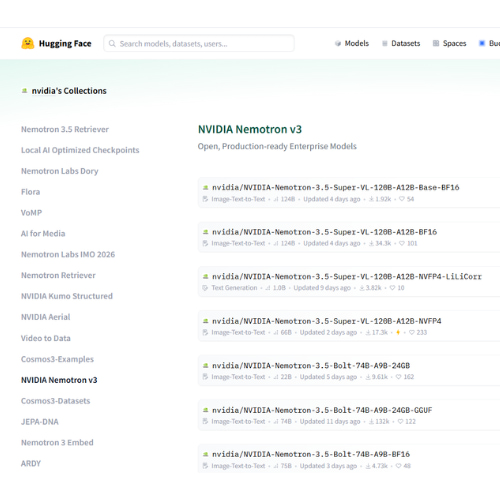
Hugging Face – Nemotron v3
NVIDIA offre inoltre i modelli come microservizi NIM, pensati per una distribuzione sicura e scalabile. Questa modalità richiede una licenza NVIDIA AI Enterprise: puoi provare i modelli e scaricare i microservizi da build.nvidia.com.
Per eseguire Nemotron su larga scala, puoi utilizzare strumenti NVIDIA come Dynamo, TensorRT-LLM e NIM, oppure librerie open source come SGLang e vLLM.
Nemotron per le aziende: come valutare il modello adatto
Per scegliere un modello Nemotron, il primo passo è provarlo su un’attività che conosci bene. Raccogli alcuni task del tuo team e definisci il risultato atteso, così da poter confrontare le risposte con un riferimento concreto.
Se stai costruendo un assistente documentale, per esempio, verifica che trovi le informazioni corrette e segnali ciò che manca nei materiali. Se invece stai lavorando su un agente collegato a un gestionale, controlla con attenzione le chiamate agli strumenti: deve scegliere la funzione appropriata e inviarle i dati corretti.
Considera poi quanto costa completare correttamente un’attività. Un modello veloce può richiedere numerose correzioni; mentre la versione più potente del modello potrebbe risolvere lo stesso compito con meno interventi.
L’esecuzione locale richiede inoltre persone in grado di mantenere il servizio e aggiornarlo. Avere una GPU compatibile è il primo requisito tecnico. Ma per usare il sistema ogni giorno servirebbe anche un gruppo di persone preparate, in modo da valutarne il comportamento.
Data Masters per le aziende: formazione su AI e Data
Con l’AI Education Academy, Data Masters propone proprio dei percorsi di formazione AI per le aziende. L’obiettivo è aiutare i team ad acquisire le competenze necessarie per valutare le tecnologie e applicarle con metodo al proprio lavoro.
In ogni caso, il nostro consiglio è di iniziare con un piccolo incarico. Dopo aver verificato i risultati, potrai identificare i passaggi da affidare all’agente e quelli che, invece, richiedono la revisione di una persona.

AUTORE:Simone Truglia Apri profilo LinkedIn
Simone è un Ingegnere Informatico con specializzazione nei sistemi automatici e con una grande passione per la matematica, la programmazione e l’intelligenza artificiale. Ha lavorato con diverse aziende europee, aiutandole ad acquisire e ad estrarre il massimo valore dai principali dati a loro disposizione.


